Chat
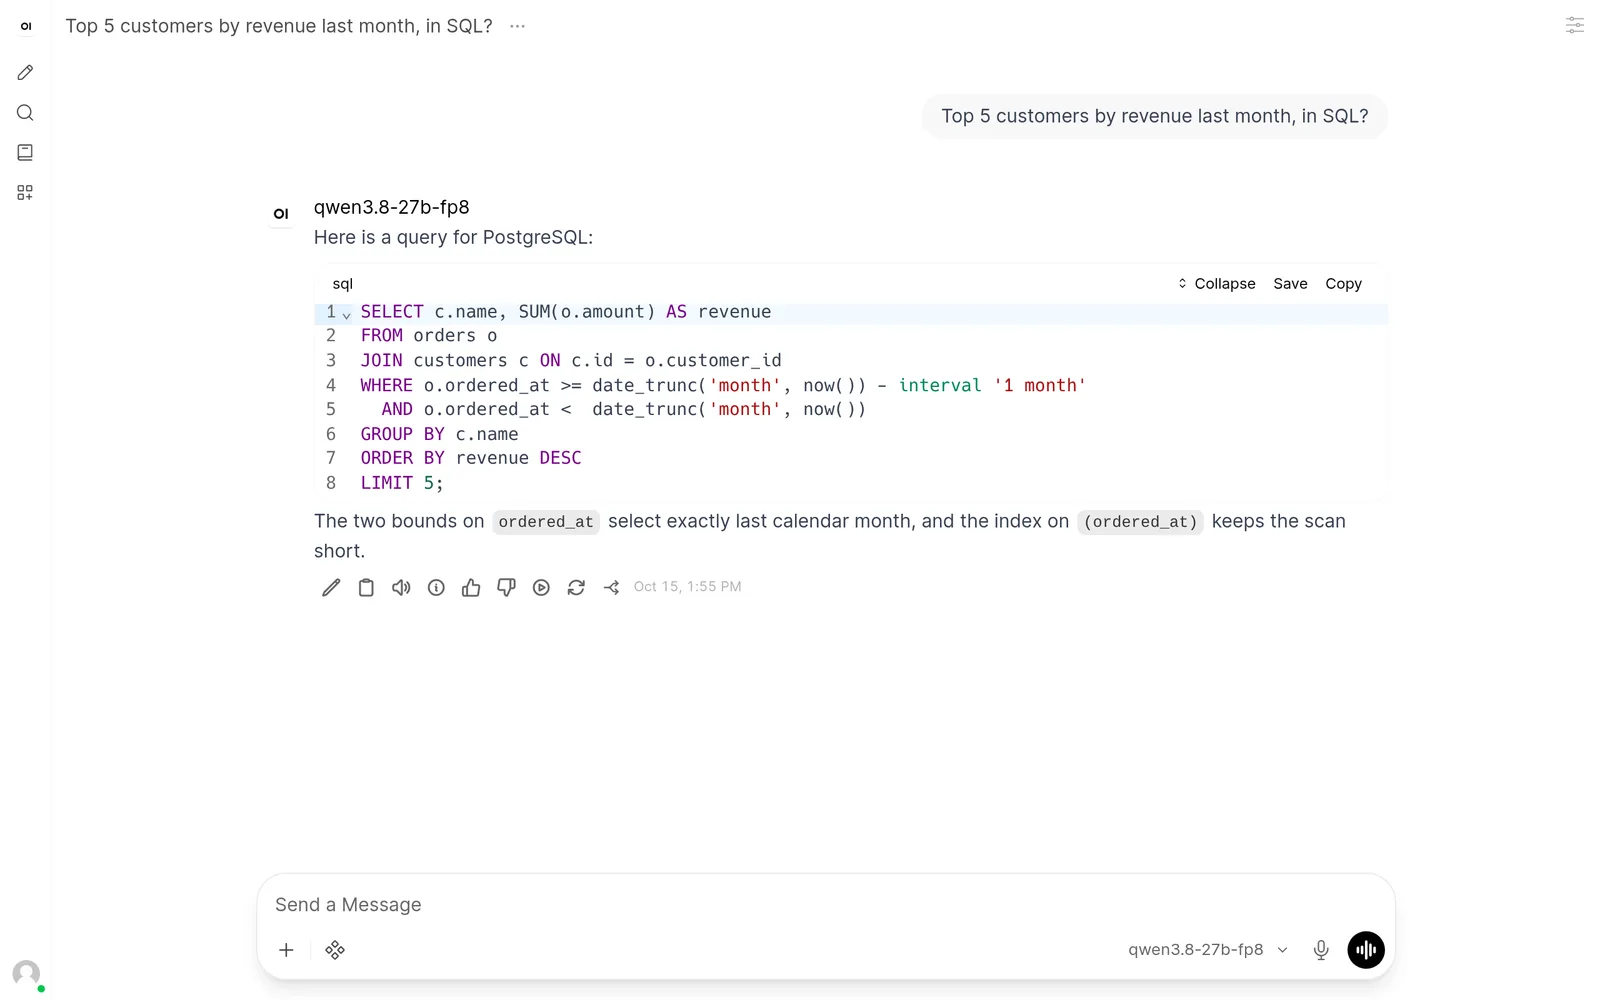
Open WebUI, connecté à votre compte, à un clic d'une machine en marche.
Choisissez un modèle et un GPU sur une place de marché en direct. Obtenez un endpoint compatible OpenAI, un chat et un espace de code dessus.
Lancer un modèleParcourez les offres GPU en direct sans compte.
Traffic
GPU load
| Component | Usage | Provider rate | Provider cost | Account billed |
|---|---|---|---|---|
| GPU | 0.750 hours | $0.380/hour | $0.29 | $0.33 |
| Storage | 0.750 hours | $0.020/hour | $0.02 | $0.02 |
| Download | 30.9 GB | $0.00/GB | $0.00 | $0.00 |
6m 12s
+0sEndpoint ready
Up to 32 users · Smooth up to 1 user
| Users | Feels | First token p50 / p90 | Speed per user | Total output |
|---|---|---|---|---|
| 1 | Smooth | 0.2 / 0.3 s | 38 tok/s | 38 tok/s |
| 16 | Overloaded | 60 / 115 s | 38 tok/s | 38 tok/s |
| 32 | Overloaded | 124 / 236 s | 38 tok/s | 38 tok/s |
Check it with curl
curl https://inference.llm-launcher.com/v1/chat/completions \
  -H "Authorization: Bearer $LLM_SAAS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model":"qwen3.8-27b-fp8","messages":[{"role":"user","content":"Hello"}]}'Dès quelques centimes de l'heure. Tarif du fournisseur plus 15 %, par minute entamée. Prépayé, sans abonnement.
| GPU | VRAM | Par heure |
|---|---|---|
| RTX 3060 | 12 Go | 0,07 $ |
| RTX 3090 | 24 Go | 0,19 $ |
| RTX A6000 | 48 Go | 0,40 $ |
| RTX 4090 | 24 Go | 0,51 $ |
| L40S | 48 Go | 0,64 $ |
| RTX 5090 | 32 Go | 0,73 $ |
| A100 SXM4 | 80 Go | 0,80 $ |
| H100 SXM | 80 Go | 2,93 $ |
| H200 | 141 Go | 4,34 $ |
| B200 | 192 Go | 8,13 $ |
Offres disponibles
 12 GB total VRAM
 PL
 AMD Ryzen 5 5600X · 12 cores32 GB RAM
 ↓ 940 · ↑ 860 Mb/sTraffic not billed by this host24 GB total VRAMDEAMD Ryzen 9 5950X · 32 cores64 GB RAM↓ 2,400 · ↑ 1,800 Mb/sTraffic at $1.00 per TB192 GB total VRAMUSIntel Xeon Platinum 8570 · 56 cores512 GB RAM↓ 9,800 · ↑ 9,400 Mb/sTraffic not billed by this host24 GB total VRAMSEAMD EPYC 7543 · 32 cores128 GB RAM↓ 3,100 · ↑ 2,900 Mb/sTraffic at $4.00 per TB48 GB total VRAMROIntel Core i9-12900K · 24 cores64 GB RAM↓ 910 · ↑ 810 Mb/sTraffic not billed by this host80 GB total VRAMCAAMD EPYC 9354 · 64 cores256 GB RAM↓ 8,600 · ↑ 8,100 Mb/sTraffic not billed by this host48 GB total VRAMFIAMD EPYC 7302 · 32 cores128 GB RAM↓ 1,900 · ↑ 1,700 Mb/sTraffic at $9.00 per TB141 GB total VRAMUSIntel Xeon Platinum 8468 · 48 cores384 GB RAM↓ 9,200 · ↑ 8,800 Mb/sTraffic not billed by this host32 GB total VRAMFRAMD Ryzen 9 9950X · 32 cores96 GB RAM↓ 2,000 · ↑ 1,900 Mb/sTraffic at $1.00 per TB80 GB total VRAMNLAMD EPYC 7763 · 64 cores256 GB RAM↓ 5,400 · ↑ 5,100 Mb/sTraffic at $16.00 per TB48 GB total VRAMJPIntel Xeon Gold 6430 · 32 cores192 GB RAM↓ 4,200 · ↑ 3,900 Mb/sTraffic at $4.00 per TB
Dans le navigateur, ou dans les outils que vous utilisez déjà.
Open WebUI, connecté à votre compte, à un clic d'une machine en marche.
OpenCode dans le navigateur, branché sur le modèle que vous avez lancé, qui modifie son espace de travail.
Votre modèle parle l'API OpenAI. Branchez-le sur votre application, un OpenCode local, un framework d'agents ou un script : pointez-le sur une URL, gardez votre code.
La facturation démarre dès que la machine est louée, démarrage et téléchargement du modèle compris, et s'arrête quand vous la détruisez. Chaque minute entamée est facturée. Un lancement qui échoue n'est facturé que pour les minutes où la machine a été louée.
Un catalogue choisi de modèles Qwen à poids ouverts, d'un 2B qui tient sur une carte de 12 Go à un 27B en BF16 ou en FP8. Chacun est dimensionné selon la mémoire GPU qu'il lui faut : vous ne voyez que les machines où il tient.
Tout GPU d'un hôte Vast.ai vérifié, de capacité de calcul 8.0 ou plus, avec un pilote CUDA récent : de la RTX 3060 aux RTX 4090 et 5090, à l'A100, la L40S, la H100, la H200 et la B200. La page de lancement ne liste que les machines dont la mémoire peut accueillir le modèle choisi.
Oui. Chaque modèle est servi par vLLM derrière un endpoint /v1 compatible OpenAI. Pointez-y un SDK OpenAI, OpenCode ou tout client qui accepte une URL de base, avec une clé d'API de votre compte.
En général quelques minutes. La page de lancement affiche chaque étape en direct (réservation, location, démarrage, connexion, téléchargement, lancement du moteur) et vous pouvez détruire la machine à chacune d'elles.
Le crédit est prépayé et rechargé par carte. Une machine dont le propriétaire n'a plus de crédit est arrêtée automatiquement : votre solde ne devient jamais négatif.
Non. Les offres GPU en direct sont ouvertes à tous. Lancer un modèle demande un compte gratuit et un peu de crédit.
De la place de marché Vast.ai. Vous choisissez l'offre exacte ; elle affiche le tarif horaire du fournisseur, et une commission de 15 % s'ajoute à ce qui vous est facturé.